

6 bài học khi xây dựng môi trường Staging & Production cho hệ thống doanh nghiệp
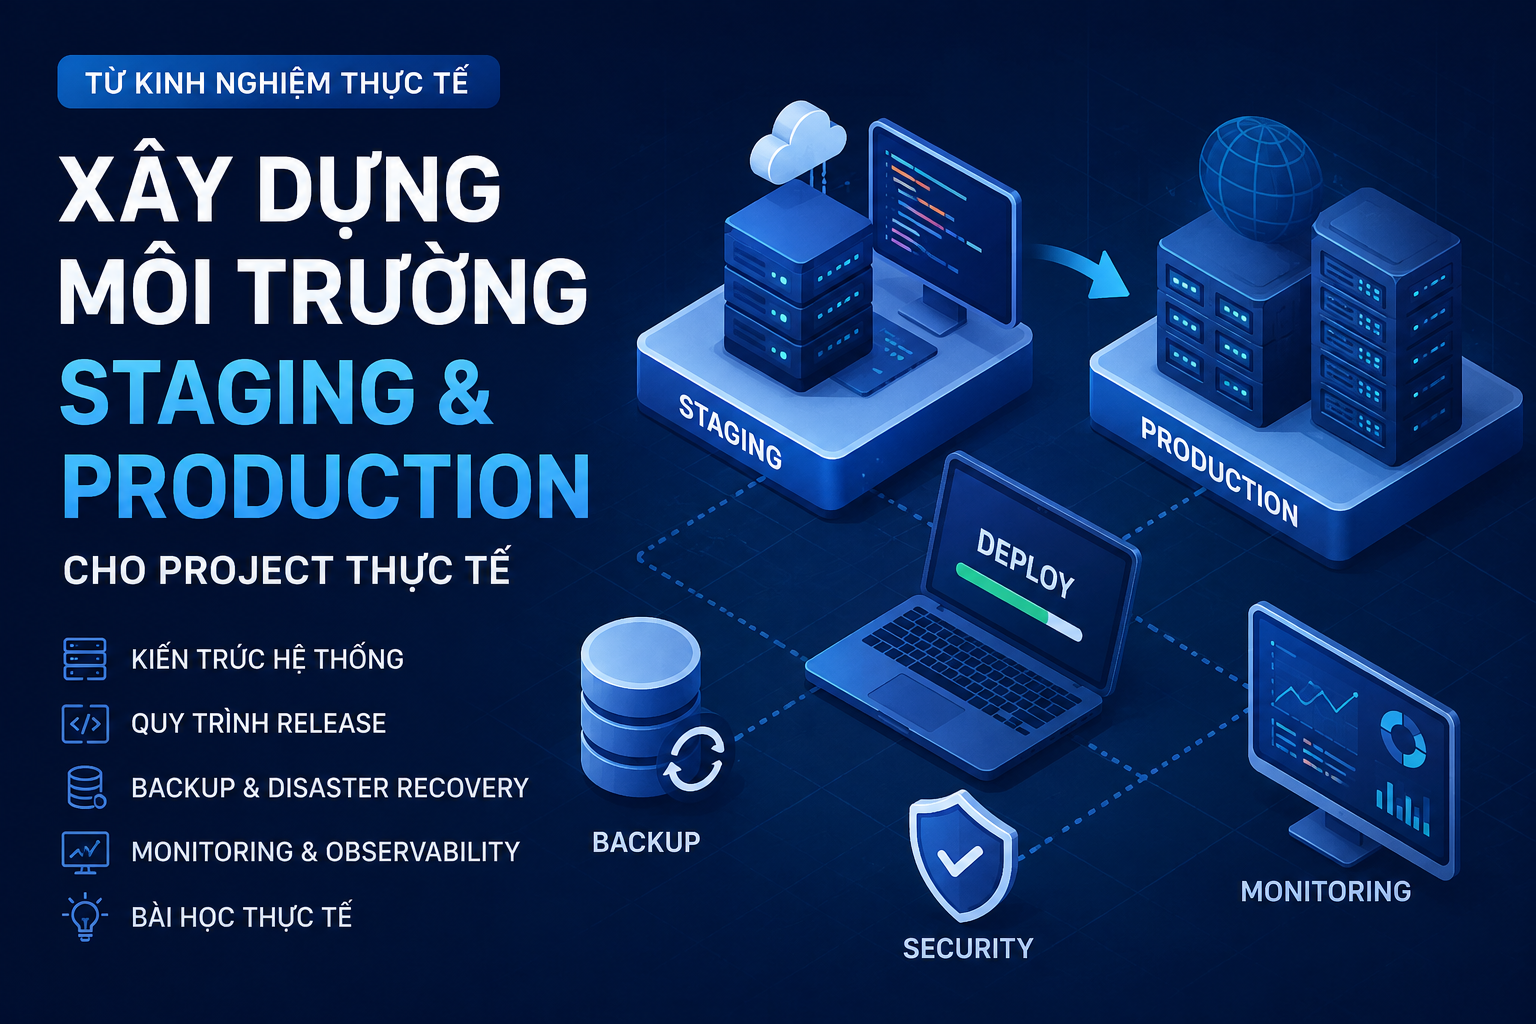
Chia sẻ những kinh nghiệm thực tế khi xây dựng môi trường Staging và Production cho hệ thống doanh nghiệp, từ thiết kế kiến trúc, quy trình Release, Backup đến Monitoring nhằm nâng cao tính ổn định và khả năng mở rộng của hệ thống.
Khi một Server không còn đủ
Khi bắt đầu một dự án mới, việc triển khai toàn bộ hệ thống trên một server duy nhất là lựa chọn khá phổ biến. Chỉ với một máy chủ, nhóm phát triển có thể nhanh chóng đưa sản phẩm vào sử dụng, tiết kiệm chi phí hạ tầng và giảm thời gian thiết lập ban đầu.
Trong giai đoạn đầu, cách làm này hoàn toàn hợp lý.
Developer có thể trực tiếp triển khai phiên bản mới, kiểm thử tính năng vừa phát triển và xử lý lỗi ngay trên cùng một môi trường. Khi số lượng thành viên còn ít và tần suất release chưa nhiều, mô hình này thường đáp ứng tốt nhu cầu của dự án.
Tuy nhiên, khi hệ thống dần phát triển, số lượng thành viên tăng lên, khách hàng bắt đầu tham gia kiểm thử (UAT) và dữ liệu trở nên quan trọng hơn, những hạn chế của mô hình “một server” bắt đầu xuất hiện.
Một số tình huống rất quen thuộc có thể xảy ra:
- Một Developer vừa triển khai phiên bản mới trong khi QA vẫn đang kiểm thử phiên bản trước.
- Một lỗi cần rollback gấp nhưng lại ảnh hưởng đến các tính năng khác đang được phát triển.
- Database bị chỉnh sửa trong quá trình kiểm thử khiến kết quả giữa các thành viên không còn đồng nhất.
- Không có bản sao dữ liệu đáng tin cậy để khôi phục khi xảy ra sự cố.
- Không ai chắc chắn chính xác phiên bản nào đang chạy trên hệ thống.
Những vấn đề này không xuất phát từ chất lượng của source code, mà đến từ việc quy trình vận hành chưa theo kịp sự phát triển của dự án.
Trong quá trình triển khai nhiều hệ thống doanh nghiệp, chúng tôi nhận ra rằng việc đầu tư vào kiến trúc hạ tầng và quy trình vận hành từ sớm mang lại giá trị lớn hơn rất nhiều so với việc chỉ tập trung tối ưu source code.
Bài viết này chia sẻ những kinh nghiệm thực tế khi xây dựng môi trường Staging và Production cho hệ thống doanh nghiệp, từ cách phân chia môi trường, thiết kế kiến trúc, quy trình Release cho đến Backup và Monitoring.
Mục tiêu không phải là giới thiệu một mô hình duy nhất đúng cho mọi dự án, mà là chia sẻ những nguyên tắc giúp hệ thống dễ mở rộng, dễ vận hành và giảm thiểu rủi ro trong quá trình phát triển lâu dài.
1. Khi nào một server không còn phù hợp?
Một server duy nhất thường hoạt động tốt trong giai đoạn Proof of Concept (PoC) hoặc khi đội ngũ phát triển chỉ có một vài thành viên. Tuy nhiên, khi quy mô dự án tăng lên, nhiều hoạt động bắt đầu diễn ra song song:
- Nhiều tính năng được phát triển cùng lúc.
- QA cần một môi trường ổn định để kiểm thử.
- Khách hàng cần môi trường UAT trước khi phát hành.
- Production phải luôn đảm bảo tính sẵn sàng.
Lúc này, việc tất cả cùng sử dụng một môi trường sẽ tạo ra xung đột và làm tăng nguy cơ phát sinh lỗi.
Một ví dụ điển hình
09:00 Developer A deploy Feature X
09:30 QA bắt đầu kiểm thử Feature W
10:00 Developer B sửa lỗi Feature Y
10:15 Database được cập nhật để phục vụ việc test
10:30 QA phát hiện lỗi nhưng không xác định được do Feature W hay Feature Y
Khi không có sự tách biệt giữa các môi trường, việc xác định nguyên nhân của lỗi trở nên khó khăn hơn rất nhiều.
Bài học rút ra: Một môi trường kiểm thử chỉ thực sự có giá trị khi nó đủ ổn định để phản ánh chính xác phiên bản sẽ được triển khai lên Production.
2. Thiết kế kiến trúc: Tách biệt để hệ thống vận hành ổn định
Khi những hạn chế của mô hình “một server” bắt đầu xuất hiện, câu hỏi tiếp theo không phải là “Nên mua thêm bao nhiêu server?”, mà là “Nên phân chia vai trò của từng server như thế nào?”
Trong thực tế, nhiều dự án ban đầu chỉ bổ sung thêm tài nguyên cho máy chủ hiện có (CPU, RAM hoặc dung lượng lưu trữ). Điều này có thể giúp cải thiện hiệu năng trong ngắn hạn, nhưng không giải quyết được vấn đề cốt lõi về kiến trúc.
Một hệ thống doanh nghiệp không chỉ cần đủ mạnh, mà còn cần dễ vận hành, dễ bảo trì và dễ mở rộng.
Đó là lý do chúng tôi lựa chọn tách biệt các thành phần theo đúng chức năng thay vì tiếp tục mở rộng một server duy nhất.
Kiến trúc đề xuất
Một mô hình triển khai phổ biến có thể được mô tả như sau:
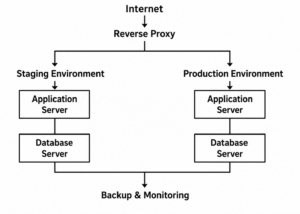
Đây không phải là mô hình duy nhất, nhưng là cách phân chia vai trò rõ ràng giúp giảm đáng kể rủi ro trong quá trình vận hành.
Application Server – Nơi xử lý toàn bộ nghiệp vụ
Application Server là nơi triển khai source code và xử lý các yêu cầu từ người dùng.
Tùy theo công nghệ sử dụng, server này có thể bao gồm:
- Web Server (Nginx, Apache…)
- Application Runtime
- Background Worker
- Queue Worker
- Scheduler (Cron Job)
- Cache (Redis…)
Điều quan trọng là Application Server không nên trở thành nơi lưu trữ mọi thứ.
Nếu Application Server vừa chạy ứng dụng, vừa lưu dữ liệu, vừa thực hiện backup và xử lý các tác vụ nền với khối lượng lớn, khả năng ảnh hưởng lẫn nhau sẽ rất cao.
Ví dụ, một tác vụ backup lớn có thể làm tăng mức sử dụng I/O, khiến thời gian phản hồi của ứng dụng tăng lên trong giờ cao điểm.
Bài học rút ra: Hãy để Application Server tập trung vào đúng nhiệm vụ của nó: phục vụ ứng dụng.
Database Server – Tài sản quan trọng nhất của hệ thống
Trong hầu hết các hệ thống doanh nghiệp, dữ liệu luôn có giá trị lớn hơn source code.
Source code có thể lấy lại từ hệ thống quản lý phiên bản, nhưng dữ liệu phát sinh từ khách hàng thì gần như không thể tái tạo nếu bị mất.
Vì vậy, Database Server cần được xem là một thành phần độc lập với những nguyên tắc riêng:
- Chỉ cho phép các máy chủ cần thiết truy cập.
- Hạn chế đăng nhập trực tiếp bằng tài khoản quản trị.
- Theo dõi dung lượng lưu trữ và hiệu năng định kỳ.
- Có cơ chế backup và kiểm tra khả năng khôi phục dữ liệu.
Việc tách Database Server ra khỏi Application Server không chỉ giúp tối ưu hiệu năng mà còn tăng tính an toàn trong quá trình bảo trì và nâng cấp.
Backup Server – Chuẩn bị cho tình huống xấu nhất
Một quan niệm khá phổ biến là:
“Chúng tôi đã có backup.”
Nhưng một câu hỏi quan trọng hơn là:
“Nếu Production gặp sự cố ngay lúc này, bạn có thể khôi phục hệ thống trong bao lâu?”
Backup chỉ thực sự có giá trị khi:
- Dữ liệu được lưu trên một hệ thống độc lập.
- Có nhiều phiên bản backup theo thời gian.
- Đã từng thực hiện kiểm tra quy trình khôi phục.
- Có tài liệu hướng dẫn restore rõ ràng.
Trong nhiều dự án, Backup Server thường bị xem là thành phần phụ. Tuy nhiên, chính nó lại là “điểm tựa” cuối cùng khi xảy ra sự cố ngoài mong muốn.
Monitoring – Phát hiện sự cố trước khi người dùng phát hiện
Một hệ thống ổn định không phải là hệ thống không bao giờ xảy ra lỗi.
Đó là hệ thống có khả năng phát hiện và phản ứng nhanh khi lỗi xuất hiện.
Thay vì chỉ theo dõi trạng thái “Server còn hoạt động hay không”, Monitoring nên bao quát nhiều chỉ số quan trọng hơn:
- CPU và Memory
- Dung lượng ổ đĩa
- Trạng thái Queue
- Cron Job
- Log bất thường
- Thời gian phản hồi của ứng dụng
- Kết nối đến Database hoặc các dịch vụ bên ngoài
Khi có cảnh báo sớm, nhóm vận hành có thể xử lý trước khi vấn đề ảnh hưởng đến người dùng cuối.
Thiết kế kiến trúc không có đáp án duy nhất
Không có một kiến trúc nào phù hợp với mọi dự án.
Một startup với vài nghìn người dùng sẽ có nhu cầu rất khác so với một hệ thống xử lý hàng triệu bản ghi mỗi ngày.
Điều quan trọng không phải là có bao nhiêu server, mà là mỗi thành phần đều có một vai trò rõ ràng, dễ mở rộng và dễ thay thế khi cần.
Một kiến trúc tốt không chỉ giải quyết nhu cầu hiện tại mà còn tạo nền tảng để hệ thống phát triển trong tương lai mà không phải thay đổi toàn bộ cách vận hành.
Bài học rút ra: Thay vì đầu tư vào một máy chủ mạnh hơn, hãy đầu tư vào một kiến trúc hợp lý. Khi vai trò của từng thành phần được xác định rõ ràng, việc mở rộng, bảo trì và xử lý sự cố sẽ trở nên đơn giản hơn rất nhiều.
3. Quy trình Release: Đừng để Production trở thành nơi kiểm thử đầu tiên
Một kiến trúc tốt giúp hệ thống ổn định, nhưng điều quyết định chất lượng của mỗi lần phát hành lại nằm ở quy trình Release.
Trong nhiều dự án, chúng ta thường bắt gặp những tình huống như:
- Developer hoàn thành tính năng và triển khai trực tiếp lên Production.
- QA kiểm thử trên phiên bản khác với phiên bản sẽ phát hành.
- Khách hàng phát hiện lỗi ngay sau khi Release.
- Khi cần rollback, không ai biết chính xác phiên bản trước đó là gì.
Những sự cố này không phải lúc nào cũng xuất phát từ lỗi lập trình. Phần lớn bắt nguồn từ việc thiếu một quy trình triển khai thống nhất.
Một quy trình Release rõ ràng giúp mọi thành viên trong nhóm biết được phiên bản nào đang ở giai đoạn nào, ai chịu trách nhiệm và điều kiện để chuyển sang bước tiếp theo là gì.
Mỗi môi trường chỉ nên có một mục đích
Một trong những sai lầm phổ biến là sử dụng Staging như một “Production thu nhỏ”, nơi mọi người cùng làm mọi việc.
Thực tế, mỗi môi trường nên có một vai trò rõ ràng:
| Môi trường | Mục đích |
|---|---|
| Development | Phát triển và kiểm tra chức năng mới. Có thể thay đổi thường xuyên. |
| Staging | Kiểm thử tích hợp, kiểm thử nghiệp vụ và xác nhận trước khi phát hành. Cấu hình nên gần giống Production nhất có thể. |
| Production | Phục vụ người dùng cuối. Chỉ triển khai các phiên bản đã được xác nhận. |
Khi ranh giới giữa các môi trường bị xóa nhòa, việc xác định nguyên nhân của sự cố sẽ trở nên khó khăn và rủi ro phát hành cũng tăng lên đáng kể.
Bài học rút ra: Mỗi môi trường chỉ nên có một mục tiêu rõ ràng. Điều này giúp giảm xung đột và tăng tính ổn định trong toàn bộ vòng đời phát triển phần mềm.
Một quy trình Release tham khảo
Mỗi tổ chức sẽ có quy trình riêng, tuy nhiên hầu hết đều xoay quanh các bước cơ bản dưới đây:
Developer hoàn thành tính năng
│
▼
Code Review
│
▼
Deploy lên Development
│
▼
Internal Testing
│
▼
Deploy lên Staging
│
▼
QA / UAT xác nhận
│
▼
Backup dữ liệu Production
│
▼
Deploy Production
│
▼
Smoke Test
│
▼
Monitoring sau Release
Sau khi triển khai, nhóm vận hành vẫn cần theo dõi các chỉ số quan trọng trong một khoảng thời gian để phát hiện sớm những vấn đề chỉ xuất hiện dưới tải thực tế.
Luôn chuẩn bị kế hoạch Rollback
Không có hệ thống nào đảm bảo mỗi lần Release đều thành công tuyệt đối.
Thay vì chỉ tập trung vào cách triển khai phiên bản mới, hãy chuẩn bị trước phương án quay lại phiên bản ổn định gần nhất.
Một kế hoạch Rollback nên trả lời được các câu hỏi sau:
- Phiên bản ổn định trước đó là phiên bản nào?
- Mất bao lâu để quay lại phiên bản cũ?
- Database có thay đổi cấu trúc hay dữ liệu không?
- Sau khi Rollback cần kiểm tra những thành phần nào?
Việc chuẩn bị trước những nội dung này giúp nhóm phát triển bình tĩnh hơn khi xảy ra sự cố và giảm đáng kể thời gian gián đoạn dịch vụ.
Bài học rút ra: Một Release Plan chỉ thực sự hoàn chỉnh khi đi kèm với một Rollback Plan.
Backup trước mỗi lần Release
Một nguyên tắc đơn giản nhưng rất dễ bị bỏ qua:
Không nên Release nếu chưa có bản backup phù hợp.
Ngay cả những thay đổi nhỏ cũng có thể ảnh hưởng đến dữ liệu hoặc gây ra lỗi không mong muốn.
Thông thường, trước mỗi lần phát hành lên Production, nhóm vận hành nên thực hiện:
- Backup cơ sở dữ liệu.
- Kiểm tra trạng thái hệ thống.
- Xác nhận dung lượng lưu trữ còn đủ.
- Đảm bảo các dịch vụ nền (Queue, Scheduler…) đang hoạt động bình thường.
- Thông báo thời gian Release nếu có khả năng ảnh hưởng đến người dùng.
Checklist này không giúp loại bỏ hoàn toàn rủi ro, nhưng giúp giảm đáng kể khả năng bỏ sót các bước quan trọng.
Sau khi Release là giai đoạn quan trọng nhất
Nhiều nhóm phát triển xem việc Deploy thành công là điểm kết thúc.
Trong thực tế, đây mới chỉ là điểm bắt đầu của giai đoạn theo dõi.
Một số lỗi chỉ xuất hiện khi hệ thống hoạt động dưới tải thực tế, chẳng hạn:
- Queue tăng đột biến.
- Bộ nhớ sử dụng tăng liên tục.
- Cron Job không thực thi.
- Kết nối tới dịch vụ bên ngoài gặp gián đoạn.
- Thời gian phản hồi tăng bất thường.
Nếu có hệ thống Monitoring và Alert phù hợp, nhóm vận hành sẽ phát hiện những dấu hiệu này trước khi chúng ảnh hưởng đến người dùng.
Đó cũng là lý do tại sao nhiều tổ chức vẫn duy trì giai đoạn Hypercare trong vài giờ hoặc vài ngày sau mỗi lần Release.
Xây dựng văn hóa Release an toàn
Bên cạnh quy trình và công cụ, yếu tố quan trọng nhất vẫn là sự thống nhất trong cách làm việc của cả nhóm.
Một quy trình Release tốt không phụ thuộc vào một cá nhân duy nhất mà cần được mọi thành viên tuân thủ.
Khi mỗi lần phát hành đều đi qua các bước kiểm tra giống nhau, khả năng phát sinh lỗi sẽ giảm dần theo thời gian và việc bàn giao giữa các thành viên cũng trở nên đơn giản hơn.
Bài học rút ra: Một quy trình Release hiệu quả không chỉ giúp triển khai nhanh hơn, mà còn tạo sự tin tưởng giữa đội ngũ phát triển, QA và khách hàng.
4. Backup & Disaster Recovery: Giá trị của Backup chỉ được chứng minh khi bạn Restore thành công
Có một câu hỏi mà mình rất thích đặt ra khi trao đổi về vận hành hệ thống:
Nếu Production gặp sự cố ngay lúc này, nhóm của bạn cần bao lâu để khôi phục toàn bộ hệ thống?
Nếu câu trả lời là:
- “Chắc khoảng vài tiếng…”
- “Để xem lại tài liệu…”
- “Hình như có backup…”
- “Để hỏi anh DevOps…”
thì rất có thể hệ thống vẫn chưa thực sự sẵn sàng cho Production.
Trong nhiều dự án, backup thường được xem như một công việc định kỳ: thiết lập Cron Job, tạo file backup và lưu vào một thư mục trên server. Khi nhìn vào danh sách các file .sql được tạo mỗi ngày, mọi người đều cảm thấy yên tâm rằng dữ liệu đã được bảo vệ.
Nhưng thực tế, sự tồn tại của một file backup không đồng nghĩa với khả năng khôi phục hệ thống.
Backup không phải là mục tiêu, Restore mới là mục tiêu
Hãy tưởng tượng một tình huống đơn giản.
Một bản cập nhật vô tình xóa nhầm dữ liệu quan trọng hoặc một lỗi phần cứng khiến Database Server không thể khởi động.
Lúc này, câu hỏi không còn là:
“Chúng ta có backup không?”
mà là:
“Chúng ta có thể khôi phục hệ thống nhanh và chính xác đến mức nào?”
Đó là điểm khác biệt giữa một hệ thống có backup và một hệ thống có khả năng phục hồi (Recoverable System).
Một chiến lược Backup hiệu quả luôn phải được thiết kế xoay quanh quá trình Restore.
Bài học rút ra: Giá trị của Backup không nằm ở số lượng file được tạo ra, mà nằm ở khả năng đưa hệ thống hoạt động trở lại khi sự cố xảy ra.
Thiết kế Backup theo nguyên tắc độc lập
Một sai lầm khá phổ biến là lưu file backup ngay trên chính Database Server.
Thoạt nhìn, điều này có vẻ thuận tiện vì không cần thêm hạ tầng.
Tuy nhiên, nếu máy chủ gặp sự cố về phần cứng, ổ đĩa bị hỏng hoặc hệ điều hành không thể khởi động, cả dữ liệu gốc và file backup đều có thể mất cùng lúc.
Để giảm thiểu rủi ro, dữ liệu backup nên được lưu trên một hệ thống độc lập với Database Server.
Một mô hình đơn giản có thể như sau:
Database Server
│
Backup theo lịch định kỳ
│
▼
Backup Server
│
Lưu nhiều phiên bản
│
▼
Kiểm tra khả năng Restore
Việc tách riêng Backup Server giúp giảm thiểu rủi ro khi xảy ra sự cố trên máy chủ chính, đồng thời tạo điều kiện thuận lợi cho việc quản lý và lưu trữ nhiều phiên bản dữ liệu.
Không phải mọi bản Backup đều giống nhau
Trong thực tế, không phải lúc nào chúng ta cũng cần giữ tất cả các bản backup.
Một chiến lược lưu trữ hợp lý thường kết hợp nhiều chu kỳ khác nhau, ví dụ:
- Backup hằng ngày để phục vụ khôi phục các sự cố gần.
- Backup hằng tuần cho các thay đổi lớn.
- Backup hằng tháng nhằm đáp ứng nhu cầu lưu trữ dài hạn hoặc đối chiếu dữ liệu.
Việc thiết lập chính sách lưu giữ (Retention Policy) giúp cân bằng giữa khả năng khôi phục và chi phí lưu trữ.
Quan trọng hơn, nhóm vận hành cần biết rõ:
- Backup nào đang được giữ.
- Backup nào có thể xóa.
- Backup nào phục vụ mục đích pháp lý hoặc kiểm toán.
Tự động hóa để giảm rủi ro từ con người
Backup là một công việc lặp lại.
Nếu phụ thuộc hoàn toàn vào thao tác thủ công, khả năng quên thực hiện hoặc thực hiện sai sẽ tăng lên theo thời gian.
Do đó, quá trình Backup nên được tự động hóa càng nhiều càng tốt:
- Thực hiện theo lịch định kỳ.
- Đặt tên file thống nhất.
- Ghi log kết quả.
- Kiểm tra dung lượng.
- Thông báo khi Backup thất bại.
Khi quy trình được chuẩn hóa, nhóm vận hành có thể tập trung vào việc theo dõi và xử lý ngoại lệ thay vì thực hiện các thao tác lặp đi lặp lại.
Thử Restore định kỳ
Đây có lẽ là bước bị bỏ quên nhiều nhất.
Một file backup có thể được tạo thành công mỗi ngày trong nhiều tháng, nhưng nếu chưa từng được Restore, sẽ không ai biết chắc rằng:
- File backup có bị lỗi hay không.
- Dữ liệu có đầy đủ hay không.
- Thời gian Restore có đáp ứng yêu cầu hay không.
- Quy trình Restore có còn phù hợp với kiến trúc hiện tại hay không.
Vì vậy, bên cạnh việc tạo backup, nhóm vận hành nên định kỳ thực hiện diễn tập khôi phục trên một môi trường riêng.
Điều này không chỉ giúp xác nhận chất lượng của dữ liệu backup mà còn giúp cả nhóm quen thuộc với quy trình xử lý khi sự cố thực sự xảy ra.
Bài học rút ra: Một bản Restore thành công luôn có giá trị hơn hàng trăm file backup chưa từng được kiểm chứng.
Disaster Recovery không chỉ là câu chuyện của hạ tầng
Khi nhắc đến Disaster Recovery, nhiều người thường nghĩ ngay đến máy chủ dự phòng hoặc trung tâm dữ liệu thứ hai.
Thực tế, Disaster Recovery còn bao gồm:
- Quy trình xử lý sự cố.
- Danh sách người chịu trách nhiệm.
- Thứ tự khôi phục các dịch vụ.
- Tài liệu hướng dẫn chi tiết.
- Kịch bản liên lạc khi hệ thống gián đoạn.
Một kế hoạch càng rõ ràng thì thời gian gián đoạn dịch vụ càng được rút ngắn.
Trong những tình huống khẩn cấp, điều quan trọng nhất không phải là đưa ra quyết định thật nhanh, mà là thực hiện đúng những gì đã được chuẩn bị trước.
Chuẩn bị cho điều hy vọng sẽ không bao giờ xảy ra
Không ai xây dựng hệ thống với mong muốn một ngày nào đó phải khôi phục toàn bộ dữ liệu.
Tuy nhiên, cũng giống như việc trang bị bình chữa cháy trong một tòa nhà, mục tiêu của Backup và Disaster Recovery không phải để sử dụng mỗi ngày, mà để sẵn sàng khi điều tồi tệ nhất xảy ra.
Một hệ thống đáng tin cậy không phải là hệ thống không bao giờ gặp sự cố.
Đó là hệ thống có khả năng phục hồi nhanh, đúng quy trình và với mức ảnh hưởng thấp nhất đến người dùng.
Bài học rút ra: Điều quan trọng không phải là “liệu sự cố có xảy ra hay không”, mà là “chúng ta đã chuẩn bị tốt đến mức nào nếu sự cố xảy ra”.
5. Monitoring & Observability: Đừng đợi người dùng báo lỗi mới biết hệ thống gặp sự cố
Có một câu nói rất nổi tiếng trong lĩnh vực vận hành hệ thống:
“No news doesn’t mean good news.”
Chỉ vì không có ai báo lỗi không có nghĩa là hệ thống đang hoạt động tốt.
Trong nhiều trường hợp, người đầu tiên phát hiện sự cố không phải là đội vận hành, mà lại là khách hàng.
- “Website hôm nay chậm quá.”
- “Không tạo được đơn hàng.”
- “Không nhận được email.”
- “Ảnh sản phẩm không hiển thị.”
Khi đó, nhóm kỹ thuật mới bắt đầu đăng nhập vào server để kiểm tra log, CPU, bộ nhớ và cố gắng tìm nguyên nhân.
Đó là cách vận hành mang tính phản ứng (Reactive).
Một hệ thống trưởng thành cần hướng đến chủ động (Proactive): phát hiện vấn đề trước khi người dùng cảm nhận được ảnh hưởng.
Monitoring không chỉ là theo dõi CPU
Khi nhắc đến Monitoring, nhiều người thường nghĩ ngay đến biểu đồ CPU, RAM hoặc dung lượng ổ đĩa.
Đây là những chỉ số quan trọng, nhưng chưa đủ để phản ánh “sức khỏe” của toàn bộ hệ thống.
Ví dụ:
- CPU chỉ sử dụng 20%.
- RAM còn trống rất nhiều.
- Ổ đĩa vẫn còn dung lượng.
Nhìn qua có vẻ mọi thứ đều ổn.
Nhưng thực tế:
- Queue đã ngừng xử lý từ 30 phút trước.
- Cron Job không còn hoạt động.
- Dịch vụ gửi email bị lỗi xác thực.
- Kết nối đến hệ thống thanh toán liên tục timeout.
Nếu chỉ nhìn vào tài nguyên phần cứng, rất khó phát hiện các vấn đề này.
Vì vậy, Monitoring cần phản ánh cả hạ tầng và nghiệp vụ của hệ thống.
Bài học rút ra: Một server khỏe chưa chắc đồng nghĩa với một hệ thống khỏe.
Theo dõi từ nhiều góc độ
Trong quá trình vận hành, chúng tôi thường chia Monitoring thành nhiều lớp khác nhau.
1. Hạ tầng (Infrastructure Monitoring)
Đây là lớp cơ bản nhất.
Ví dụ:
- CPU
- Memory
- Disk
- Network
- File System
- I/O
Những chỉ số này giúp phát hiện sớm các vấn đề liên quan đến tài nguyên.
2. Dịch vụ (Service Monitoring)
Tiếp theo là theo dõi các thành phần quan trọng của hệ thống.
Ví dụ:
- Web Server
- Database
- Cache
- Queue Worker
- Scheduler
- Reverse Proxy
Mục tiêu là đảm bảo các dịch vụ luôn hoạt động đúng trạng thái mong muốn.
3. Ứng dụng (Application Monitoring)
Đây là lớp phản ánh trực tiếp chất lượng của phần mềm.
Ví dụ:
- Thời gian phản hồi API.
- Tỷ lệ lỗi.
- Số lượng request.
- Exception bất thường.
- Các tác vụ xử lý nền.
Những dữ liệu này giúp nhóm phát triển nhanh chóng xác định vấn đề khi có lỗi phát sinh.
4. Nghiệp vụ (Business Monitoring)
Đây là lớp thường bị bỏ qua nhưng lại mang nhiều giá trị nhất.
Thay vì chỉ theo dõi hệ thống, Business Monitoring tập trung vào việc theo dõi các quy trình nghiệp vụ quan trọng.
Ví dụ:
- Có bao nhiêu đơn hàng được tạo trong một giờ?
- Có giao dịch nào bị dừng bất thường không?
- Có batch nào chưa hoàn thành?
- Có sản phẩm nào chưa được đồng bộ?
- Có email nào chưa gửi thành công?
Những chỉ số này phản ánh trực tiếp tình trạng vận hành của hệ thống dưới góc nhìn của doanh nghiệp.
Bài học rút ra: Người dùng không quan tâm CPU là bao nhiêu phần trăm. Họ chỉ quan tâm chức năng họ cần có hoạt động bình thường hay không.
Alert đúng còn quan trọng hơn Alert nhiều
Một hệ thống có hàng trăm cảnh báo không đồng nghĩa với việc được giám sát tốt.
Ngược lại, quá nhiều cảnh báo có thể khiến đội vận hành bỏ qua những cảnh báo thực sự quan trọng.
Hiện tượng này thường được gọi là Alert Fatigue.
Một Alert hiệu quả nên đảm bảo:
- Phản ánh đúng mức độ nghiêm trọng.
- Có người chịu trách nhiệm xử lý.
- Có hướng dẫn xử lý ban đầu.
- Không lặp lại liên tục khi nguyên nhân chưa được giải quyết.
Thay vì cố gắng cảnh báo mọi thứ, hãy ưu tiên cảnh báo những vấn đề có thể ảnh hưởng trực tiếp đến dịch vụ.
Dashboard dành cho con người, không chỉ dành cho máy
Một Dashboard tốt không chỉ đẹp.
Nó phải giúp người xem trả lời được những câu hỏi quan trọng trong vài phút đầu tiên.
Ví dụ:
- Hệ thống có đang hoạt động bình thường không?
- Thành phần nào đang gặp vấn đề?
- Sự cố bắt đầu từ khi nào?
- Có ảnh hưởng đến người dùng không?
- Mức độ nghiêm trọng ra sao?
Nếu phải mở nhiều màn hình và đọc hàng nghìn dòng log mới hiểu chuyện gì đang xảy ra, Dashboard vẫn chưa hoàn thành nhiệm vụ của mình.
Quan sát xu hướng thay vì chỉ quan sát thời điểm
Một giá trị CPU 60% chưa nói lên nhiều điều.
Điều quan trọng hơn là:
- CPU có tăng dần trong nhiều ngày không?
- Bộ nhớ có bị rò rỉ không?
- Thời gian phản hồi có đang tăng sau mỗi lần Release?
- Dung lượng ổ đĩa sẽ đầy sau bao lâu?
Theo dõi xu hướng giúp nhóm vận hành phát hiện các vấn đề trước khi chúng trở thành sự cố.
Đó cũng là nền tảng cho việc lập kế hoạch mở rộng hạ tầng trong tương lai.
Monitoring là công cụ để học từ hệ thống
Monitoring không chỉ phục vụ việc xử lý sự cố.
Nó còn giúp nhóm phát triển hiểu rõ hơn về chính sản phẩm của mình.
Sau mỗi lần Release, Dashboard và các chỉ số vận hành sẽ trả lời những câu hỏi như:
- Hiệu năng có cải thiện không?
- Batch mới có hoạt động đúng kỳ vọng không?
- Tỷ lệ lỗi có tăng không?
- Người dùng có sử dụng tính năng mới như mong muốn không?
Khi dữ liệu vận hành được sử dụng để đưa ra quyết định, Monitoring không còn là một công cụ giám sát, mà trở thành nền tảng hỗ trợ cải tiến liên tục.
Từ Monitoring đến Observability
Monitoring giúp trả lời câu hỏi:
“Điều gì đang xảy ra?”
Trong khi đó, Observability giúp trả lời:
“Tại sao điều đó lại xảy ra?”
Để đạt được điều này, hệ thống cần kết hợp nhiều nguồn dữ liệu như:
- Metrics
- Logs
- Traces
- Events
Khi các nguồn dữ liệu này được liên kết với nhau, đội ngũ kỹ thuật có thể rút ngắn đáng kể thời gian điều tra và xử lý sự cố.
Observability không thay thế Monitoring, mà là bước phát triển tiếp theo giúp hệ thống trở nên minh bạch và dễ phân tích hơn.
Bài học rút ra: Monitoring giúp phát hiện sự cố. Observability giúp hiểu nguyên nhân. Một hệ thống vận hành hiệu quả cần cả hai.
6. Những bài học thực tế sau quá trình vận hành
Sau khi hoàn thiện kiến trúc, xây dựng quy trình Release, thiết lập cơ chế Backup và Monitoring, chúng tôi nhận ra rằng công nghệ chỉ là một phần của bài toán.
Điều quyết định sự ổn định của hệ thống trong dài hạn không nằm ở việc sử dụng framework nào, chạy trên nền tảng nào hay có bao nhiêu server.
Quan trọng hơn cả là quy trình làm việc, cách các thành viên phối hợp với nhau và tư duy vận hành được hình thành trong cả đội ngũ.
Nhìn lại quá trình triển khai, có một số bài học tưởng chừng đơn giản nhưng lại tạo ra ảnh hưởng rất lớn.
1. Đừng tối ưu quá sớm, hãy tối ưu đúng thời điểm
Ở giai đoạn đầu của dự án, rất nhiều nhóm dành nhiều thời gian để xây dựng một kiến trúc thật hoàn hảo.
Microservices.
Kubernetes.
Auto Scaling.
Multi Region.
High Availability.
Những công nghệ này đều rất tốt, nhưng không phải dự án nào cũng cần ngay từ ngày đầu tiên.
Một kiến trúc quá phức tạp có thể làm tăng chi phí vận hành, kéo dài thời gian triển khai và tạo thêm gánh nặng cho đội ngũ.
Thay vì cố gắng xây dựng một hệ thống “không bao giờ phải thay đổi”, hãy xây dựng một hệ thống có khả năng thay đổi khi cần.
Một kiến trúc đơn giản nhưng có khả năng mở rộng thường mang lại nhiều giá trị hơn một kiến trúc hiện đại nhưng vượt quá nhu cầu thực tế.
Bài học rút ra: Kiến trúc tốt không phải là kiến trúc nhiều công nghệ nhất, mà là kiến trúc phù hợp nhất với giai đoạn phát triển của sản phẩm.
2. Chuẩn hóa quy trình quan trọng hơn chuẩn hóa công nghệ
Có thể mỗi dự án sẽ sử dụng một stack công nghệ khác nhau.
Laravel.
Spring Boot.
.NET.
Node.js.
Go.
Nhưng dù sử dụng công nghệ nào, các nguyên tắc vận hành vẫn gần như giống nhau:
- Có môi trường Development.
- Có Staging để kiểm thử.
- Có Production ổn định.
- Có quy trình Release.
- Có Backup.
- Có Monitoring.
Nếu quy trình được chuẩn hóa, việc chuyển đổi công nghệ trong tương lai sẽ dễ dàng hơn rất nhiều.
Ngược lại, nếu mỗi dự án vận hành theo một cách riêng, đội ngũ sẽ mất nhiều thời gian để thích nghi và dễ phát sinh sai sót.
3. Tự động hóa những công việc lặp lại
Trong quá trình vận hành, có rất nhiều công việc được thực hiện mỗi ngày:
- Backup dữ liệu.
- Kiểm tra trạng thái dịch vụ.
- Thu thập log.
- Triển khai phiên bản mới.
- Dọn dẹp file tạm.
- Kiểm tra dung lượng ổ đĩa.
Nếu những công việc này đều được thực hiện thủ công, khả năng xảy ra sai sót sẽ tăng lên theo thời gian.
Thay vì đặt mục tiêu loại bỏ hoàn toàn sự can thiệp của con người, hãy ưu tiên tự động hóa những thao tác lặp đi lặp lại và giữ lại vai trò kiểm soát ở các bước quan trọng.
Điều này vừa giúp giảm rủi ro, vừa giúp đội ngũ có thêm thời gian tập trung vào việc phát triển sản phẩm.
Bài học rút ra: Tự động hóa không nhằm thay thế con người, mà nhằm giảm thiểu những sai sót do con người gây ra.
4. Ghi chép tài liệu ngay khi hệ thống còn “nóng”
Một vấn đề thường gặp trong các dự án là tài liệu luôn được viết sau cùng.
Khi hệ thống đã vận hành ổn định, những người trực tiếp triển khai bắt đầu quên dần các quyết định kỹ thuật, lý do lựa chọn kiến trúc hay những khó khăn đã gặp trong quá trình triển khai.
Việc ghi chép sớm sẽ giúp:
- Thành viên mới dễ tiếp cận dự án.
- Rút ngắn thời gian bàn giao.
- Giảm phụ thuộc vào cá nhân.
- Hỗ trợ điều tra sự cố khi cần.
Tài liệu không cần quá dài, nhưng nên phản ánh đúng thực tế và được cập nhật khi hệ thống thay đổi.
5. Sau mỗi sự cố, hãy cải thiện hệ thống thay vì tìm người chịu trách nhiệm
Không có hệ thống nào hoàn hảo.
Không có đội ngũ nào chưa từng gặp sự cố.
Điều tạo nên sự khác biệt giữa các tổ chức không phải là số lần xảy ra lỗi, mà là cách họ học từ những lỗi đó.
Sau mỗi sự cố, thay vì chỉ đặt câu hỏi:
“Ai là người gây ra?”
Hãy đặt thêm những câu hỏi quan trọng hơn:
- Tại sao lỗi này không được phát hiện sớm?
- Quy trình nào còn thiếu?
- Monitoring có thể cải thiện gì?
- Checklist Release cần bổ sung điều gì?
- Làm thế nào để lỗi tương tự không lặp lại?
Mỗi sự cố nên được xem là một cơ hội để hoàn thiện hệ thống.
Một quy trình tốt sẽ giúp cùng một lỗi không xảy ra lần thứ hai.
Bài học rút ra: Hãy sửa quy trình trước khi sửa con người. Một hệ thống vận hành tốt cần giảm khả năng con người mắc lỗi, thay vì kỳ vọng con người không bao giờ mắc lỗi.
6. Hạ tầng không phải mục tiêu cuối cùng
Khi mới bắt đầu làm hạ tầng, rất dễ bị cuốn vào việc xây dựng những kiến trúc ngày càng phức tạp.
Nhiều server hơn.
Nhiều dashboard hơn.
Nhiều công cụ hơn.
Tuy nhiên, điều quan trọng cần nhớ là:
Người dùng không sử dụng hạ tầng.
Họ sử dụng sản phẩm.
Mục tiêu của hạ tầng không phải là có nhiều công nghệ hiện đại, mà là tạo ra một nền tảng ổn định để đội ngũ có thể phát triển sản phẩm nhanh hơn, an toàn hơn và bền vững hơn.
Một hạ tầng “vô hình” — nơi người dùng gần như không bao giờ phải nghĩ đến việc nó đang hoạt động như thế nào — thường là dấu hiệu của một hệ thống được vận hành tốt.
Nhìn lại hành trình
Nếu phải tóm tắt toàn bộ hành trình xây dựng môi trường Staging và Production trong một câu, mình sẽ chọn:
Đừng xây dựng hạ tầng để phục vụ server, hãy xây dựng hạ tầng để phục vụ con người và sản phẩm.
Kiến trúc tốt giúp giảm rủi ro.
Quy trình tốt giúp giảm sai sót.
Monitoring tốt giúp phát hiện sớm vấn đề.
Backup tốt giúp hệ thống có thể phục hồi.
Nhưng cuối cùng, tất cả những điều đó đều hướng đến một mục tiêu duy nhất:
Giúp đội ngũ phát triển tập trung tạo ra giá trị cho người dùng, thay vì dành phần lớn thời gian để xử lý sự cố.
Bài học rút ra: Một hệ thống trưởng thành không được đánh giá bởi số lượng server hay công nghệ sử dụng, mà bởi khả năng giúp đội ngũ phát triển và vận hành làm việc hiệu quả, an toàn và bền vững trong nhiều năm.
7. Kết luận
Xây dựng hạ tầng không phải là đích đến, mà là nền tảng cho sự phát triển lâu dài
Trong suốt bài viết này, chúng ta đã cùng đi qua hành trình từ một môi trường chỉ gồm một server đến một kiến trúc Staging và Production hoàn chỉnh.
Đó không chỉ là quá trình bổ sung thêm máy chủ hay áp dụng những công nghệ mới, mà còn là quá trình thay đổi tư duy về cách xây dựng và vận hành hệ thống.
Khi dự án phát triển, số lượng người dùng tăng lên và đội ngũ mở rộng, những quyết định về hạ tầng sẽ ảnh hưởng trực tiếp đến chất lượng sản phẩm cũng như hiệu quả làm việc của cả nhóm.
Một kiến trúc hợp lý giúp giảm rủi ro.
Một quy trình Release rõ ràng giúp tăng tính ổn định.
Một chiến lược Backup và Disaster Recovery tốt giúp hệ thống luôn có khả năng phục hồi.
Một hệ thống Monitoring hiệu quả giúp phát hiện vấn đề trước khi người dùng bị ảnh hưởng.
Tất cả những yếu tố này kết hợp lại để tạo nên một nền tảng đủ vững chắc cho sự phát triển lâu dài của sản phẩm.
Không có kiến trúc nào là hoàn hảo
Một trong những điều thú vị nhất khi làm hạ tầng là không tồn tại một mô hình duy nhất đúng cho mọi dự án.
Kiến trúc phù hợp với một startup có thể hoàn toàn không phù hợp với một doanh nghiệp lớn.
Ngược lại, một hệ thống được thiết kế để phục vụ hàng triệu người dùng cũng chưa chắc là lựa chọn tối ưu cho một sản phẩm đang trong giai đoạn thử nghiệm.
Điều quan trọng không phải là chạy theo những xu hướng mới nhất, mà là lựa chọn giải pháp phù hợp với nhu cầu thực tế, đồng thời luôn để ngỏ khả năng mở rộng trong tương lai.
Một kiến trúc tốt không phải là kiến trúc nhiều công nghệ nhất.
Đó là kiến trúc mà đội ngũ có thể hiểu, vận hành và phát triển một cách bền vững.
Công nghệ sẽ thay đổi, nhưng nguyên tắc sẽ còn mãi
Có thể vài năm nữa:
- Framework sẽ thay đổi.
- Nền tảng Cloud sẽ thay đổi.
- Công cụ CI/CD sẽ thay đổi.
- Giải pháp Monitoring cũng sẽ thay đổi.
Nhưng những nguyên tắc cốt lõi vẫn sẽ còn nguyên giá trị:
- Phân tách rõ vai trò của từng môi trường.
- Chuẩn hóa quy trình Release.
- Luôn có phương án Backup và Rollback.
- Theo dõi hệ thống bằng dữ liệu thay vì cảm tính.
- Tự động hóa các công việc lặp lại.
- Liên tục cải tiến sau mỗi lần phát hành và sau mỗi sự cố.
Đó là những nguyên tắc có thể áp dụng cho hầu hết mọi dự án, bất kể quy mô hay công nghệ sử dụng.
Điều quan trọng nhất mà chúng tôi học được
Nếu phải chọn một bài học duy nhất sau quá trình xây dựng và vận hành hệ thống, đó sẽ là:
Một hệ thống ổn định không được tạo nên bởi những lần xử lý sự cố xuất sắc, mà bởi số lượng sự cố ngày càng ít đi nhờ những cải tiến liên tục trong kiến trúc và quy trình.
Mỗi lần phát hiện một điểm yếu là một cơ hội để hoàn thiện hệ thống.
Mỗi lần tối ưu quy trình là một lần giảm bớt rủi ro cho những lần phát hành tiếp theo.
Và mỗi tài liệu, mỗi checklist hay mỗi dashboard được bổ sung hôm nay đều là một khoản đầu tư giúp đội ngũ làm việc hiệu quả hơn trong tương lai.
Lời kết
Trong phát triển phần mềm, chúng ta thường dành rất nhiều thời gian để bàn về ngôn ngữ lập trình, framework hay thuật toán.
Nhưng khi sản phẩm bước vào giai đoạn vận hành thực tế, chính hạ tầng và quy trình mới là những yếu tố quyết định khả năng phát triển bền vững.
Hy vọng những kinh nghiệm được chia sẻ trong bài viết này sẽ mang lại thêm một góc nhìn thực tế cho các nhóm phát triển đang xây dựng hoặc chuẩn bị mở rộng hệ thống của mình.
Dù quy mô dự án lớn hay nhỏ, việc đầu tư đúng thời điểm cho kiến trúc, quy trình vận hành và khả năng phục hồi sẽ luôn mang lại giá trị lâu dài cho cả đội ngũ và sản phẩm.
Lời cảm ơn
Cảm ơn bạn đã dành thời gian theo dõi bài viết.
Nếu bạn có những kinh nghiệm khác trong quá trình xây dựng hoặc vận hành hệ thống, hãy chia sẻ cùng chúng tôi. Những góc nhìn thực tế từ cộng đồng luôn là nguồn kiến thức quý giá, giúp tất cả chúng ta tiếp tục học hỏi và hoàn thiện hơn mỗi ngày.
 | Nguyễn Ngô Đăng Khoa Developer |
ỨNG TUYỂN
Chế độ phúc lợi
CÔNG VIỆC TƯƠNG TỰ